🎉🎉🎉5秒で論文『Understanding the Capabilities, Limitations, and Societal Impact of Large Language Models』を理解する。
イントロの日本語訳
2020年10月14日、OpenAI、スタンフォード大学人工知能研究所(HAI)、およびその他の大学の研究者たちが、当時公開されていた最大の密な言語モデルであったGPT-3を取り巻くオープンな研究課題を議論するために集まった。
会議はチャタムハウスルールの下で行われた。討論者は、コンピュータサイエンス、言語学、哲学、政治学、コミュニケーション、サイバー政策など、多岐にわたる研究背景から参加した。広義には、議論は主に2つの問いを中心に行われた:
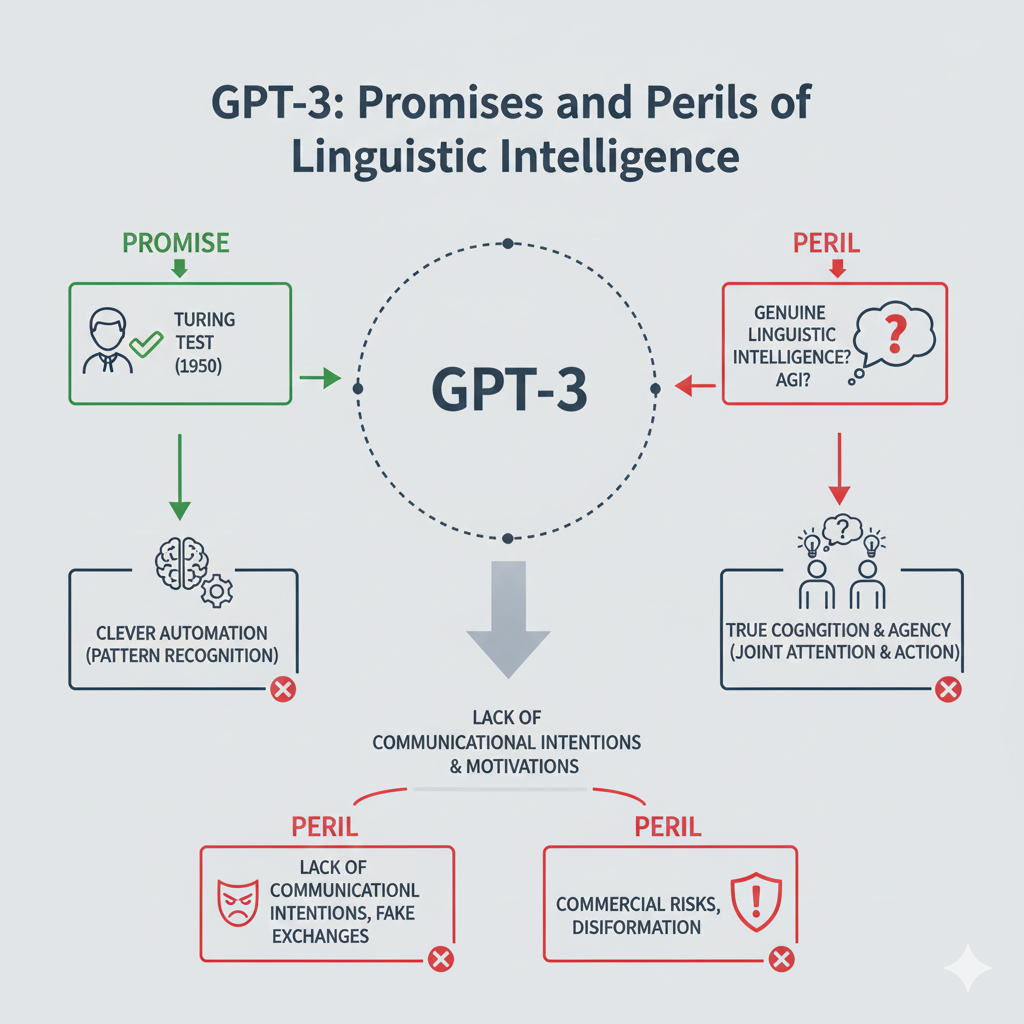
大型言語モデルの技術的な能力と限界は何か? 議論は以下を含むいくつかの主要な領域に触れた:モデルの能力に対するスケールの驚くべき影響、大型言語モデルが真に言語を理解しているかどうかを評価することの困難さ、複数のデータモダリティでモデルをトレーニングすることの重要性、そして人間の価値観とモデルの目的を一致させる(アライメント)ことにおける課題。
大型言語モデルの広範な利用による社会的影響は何か? 議論は以下を含むいくつかの主要な領域に触れた:汎用言語モデルのあらゆる可能な用途(または誤用)の範囲を特定することの困難さ、組織がモデルのデプロイメントにおいて直面する可能性のある課題、これらのモデルがアルゴリズム的に情報を拡散する可能性、モデルのバイアス(例:人種、ジェンダー、宗教など)を緩和することの困難さ、そして言語モデルベースの自動化が労働市場に与える影響。
会話は協力的で生産的であったが、これらの問いに答えることにおいて、遅すぎるよりは早く進展させるべきだという緊急感があった。ここでは、上記の2つのテーマごとに整理された議論の詳細な要約を提供する。我々は、議論から示唆を得た潜在的な将来の研究方向のリストをもって締めくくる。
出典
https://arxiv.org/pdf/2102.02503
コメント
一般知能の萌芽として捉える洞察、が優れた最初の論文の一つとしてCopilotに紹介されたのだが。。。。 イントロではわからないな。。。
